Ein Experiment von Anthropic mit 50 Fachleuten zeigt, wie stark KI-Agenten menschliche Urteile bei offenen Analysefragen lenken. In 86 Prozent der Fälle folgten die Experten einer per Münzwurf zugeteilten Neigung der KI…
Von KI geschrieben Hugging Face hat Project ProtoStar vorgestellt, das Universitäten, das Astera Institute und die Community-Gruppe ORCA zusammenbringt, um öffentlich finanzierte Datensätze, Modelle und Code in für KI geeigneten Formaten zu veröffentlichen. Zu den gründenden akademischen Mitgliedern gehören Carnegie Mellon, Purdue und drei weitere US-Universitäten, die über das Open Forum for KI zusammenarbeiten. Die erste offene Herausforderung, die Carnegie Mellon vom 2. bis 13. November 2026 durchführt, fordert Teams auf, Klimaindikatoren für 210 US-Städte für 2019–2026 vorherzusagen, und zwar auf Basis von Daten bis 2018. Hugging Face gibt an, bereits über 17.000 öffentliche Datensätze in zentralen Wissenschaftsbereichen zu hosten, und die endgültigen Ergebnisse der Herausforderung werden Anfang 2027 erwartet.
Von KI geschrieben Das neue Mistral Large 4, von Fans Le Chonk genannt, ist ein Mixture-of-Experts-Modell, das Text und Bilder verarbeitet und in Text antwortet, mit etwa 1T Parametern insgesamt, davon 49B aktiv, und einem 1M-Token-Kontext. Im Artificial Analysis Cyber Index erreichte es 82 % bei einem Test zum Nachbauen und Patchen von Schwachstellen und löste 93 % von 40 Cybench-Aufgaben. Die Gewichte stehen unter der Mistral Ecosystem Open-Weight License, die von MIT abgeleitet ist und die Nutzung als Model-as-a-Service einschränkt, während vLLM, transformers und llama.cpp sie ab dem ersten Tag unterstützen. Der Artificial Analysis Intelligence Index platzierte es am 29. Oktober 2026 auf Platz fünf unter den Modellen mit offenen Gewichten.
Von KI geschrieben Ted Sanders von OpenAI sagte, dass die Fähigkeiten von LLMs in vielen Dimensionen variieren, die Modellgröße jedoch einen großen Teil des Leistungsunterschieds erklärt. Größere Modelle seien in der Regel zuverlässiger, erinnerten obskure Fakten besser und kosteten pro Token mehr, merkte er an. Versionsnummern würden die Veröffentlichungsreihenfolge, die Verwandtschaft mit verwandten Modellen und das Ausmaß der Verbesserung signalisieren, beschrieb er. Eine hypothetische 6.1 würde beispielsweise auf 5.6 folgen, wäre aber kein so großer Sprung, dass sie als 7 bezeichnet werden könnte.
Von KI geschrieben AWS hat eine Referenzarchitektur und eine einsetzbare Blaupause für den Betrieb unternehmensweiter agentischer KI auf Amazon Bedrock und Amazon Bedrock AgentCore veröffentlicht. Das Modell ist föderiert: Ein zentrales Platform-Team betreibt gemeinsame Inferenz-Gateways, Guardrails und genehmigte Vorlagen, während Workstream-Teams ihre Agenten in isolierten Konten verwalten. Jede Workstream-Zelle erhält eigene AgentCore Runtime, Memory und Gateway, sodass ein Team Agenten bereitstellen, zurücksetzen oder außer Betrieb nehmen kann, ohne andere zu beeinträchtigen. Referenzvorlagen decken Strands, LangGraph und CrewAI ab, und eine Evaluierungspipeline prüft jeden Agenten, bevor er in die Produktion gelangt.
Von KI geschrieben AWS hat QA Studio, die Referenzlösung für natürlichsprachliches Testen auf Basis von Amazon Nova Act, um zwei Funktionen für große Organisationen erweitert. Anwendungen fassen Use Cases und Testsuiten unter einem verantwortlichen Team zusammen und melden Bestehensquote, Fehleranzahl und einen Health-Score von 0 bis 100, der bei instabilen Tests sinkt. Dafür werden benutzerdefinierte Amazon CloudWatch-Metriken verwendet, aufgeteilt nach Umgebung. Der Zugriff wird über fünf kumulative Rollen von Viewer bis Admin gesteuert, verwaltet über Amazon Cognito-Gruppen. Teams können Anwendungen mit anderen auf Ansichts-, Ausführungs- oder Vollzugriffsebene teilen, ein Benutzer erhält jedoch nie mehr Rechte, als seine eigene Rolle erlaubt.
Von KI geschrieben Auf dem Android Dev Summit sagte Google, dass Android Studio Rabbit 2 mehr als 40 externe Coding-Agenten hosten kann, darunter Codex von OpenAI und Claude Agent von Anthropic, über eine Funktion namens „Bring Your Own Agent“. Eine aktualisierte Android CLI ließ Agenten UI-Aufgaben in Googles internen Tests um 77 Prozent schneller und mit bis zu dreimal weniger Tokens erledigen. Google fügte außerdem eine Alpha-Version der Agentic API hinzu, die auf Gemini Nano 4 basiert und für On-Device-Agenten gedacht ist, sowie eine Vorschau der Connected Apps Platform, die Apps über MCP mit der Gemini-App und der Suche verbindet. Zusammen mit XREAL stellte Google die XREAL AURA vor, Android-XR-Brillen für 1.099 US-Dollar, die ab Mitte November ausgeliefert werden.
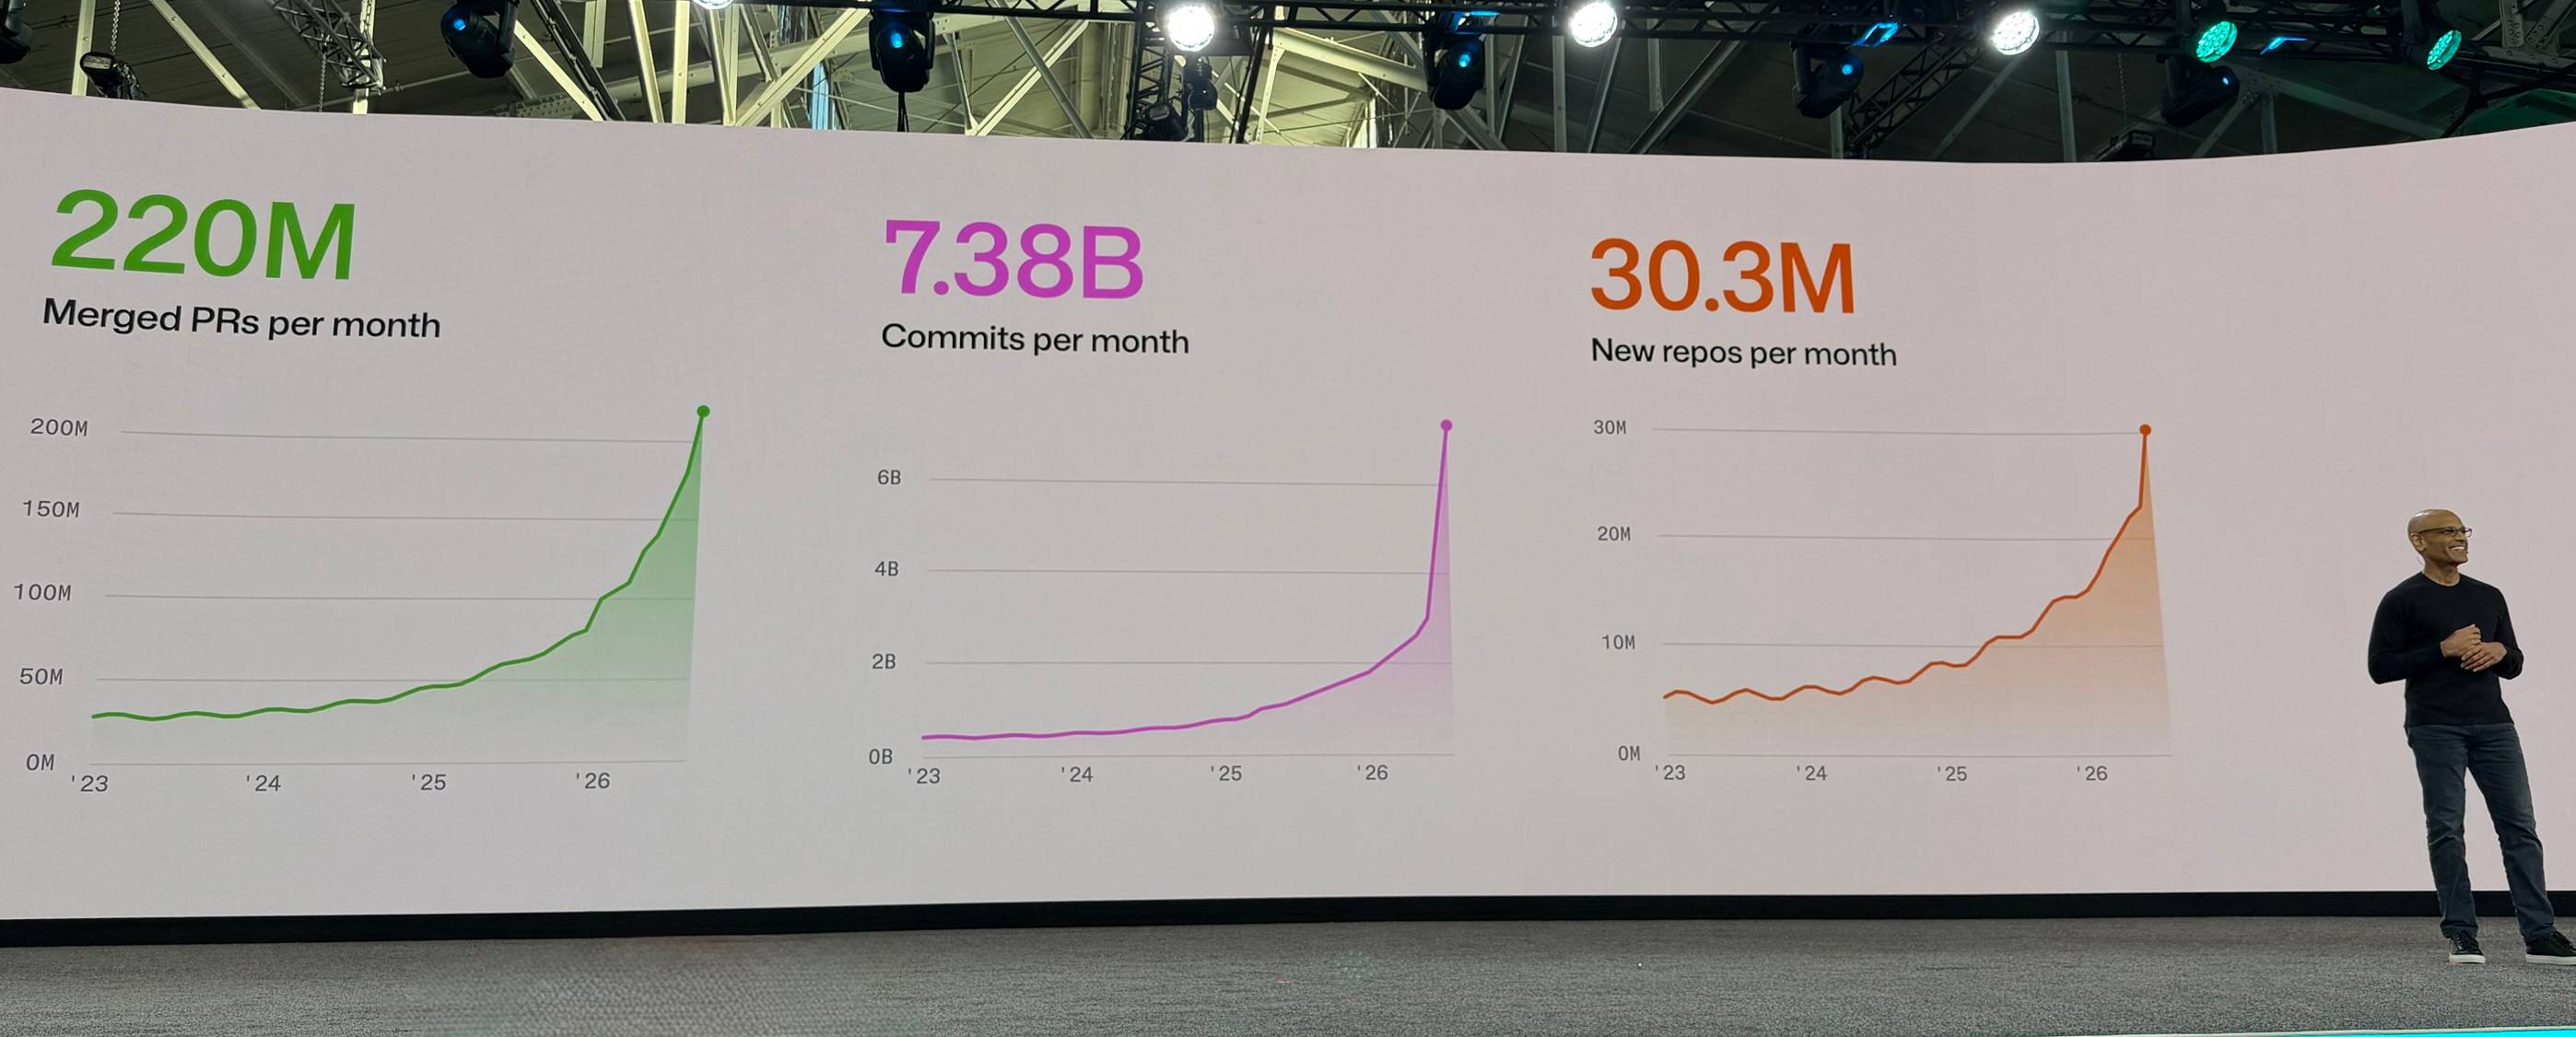
Von KI geschrieben Auf der GitHub Universe stellte Führungskraft Jay Parikh den jährlichen Octoverse-Bericht des Unternehmens vor und führte den deutlichen Anstieg der Aktivität auf Agentic Engineering zurück. Monatlich zusammengeführte Pull Requests erreichten 220 Mio., etwa das Dreifache des Niveaus von vor knapp einem Jahr, während Commits auf mehr als das Dreifache auf 7,38 Mrd. pro Monat stiegen, vor allem in der zweiten Jahreshälfte 2026. Neue Repositories verdoppelten sich auf monatlich 30,3 Mio. Der Bericht enthält außerdem Aufschlüsselungen nach Branche, klassifiziert mit einem feinabgestimmten Embedding-Modell, und zählt Projekte, die mit Interoperabilität oder Reverse Engineering zusammenhängen.
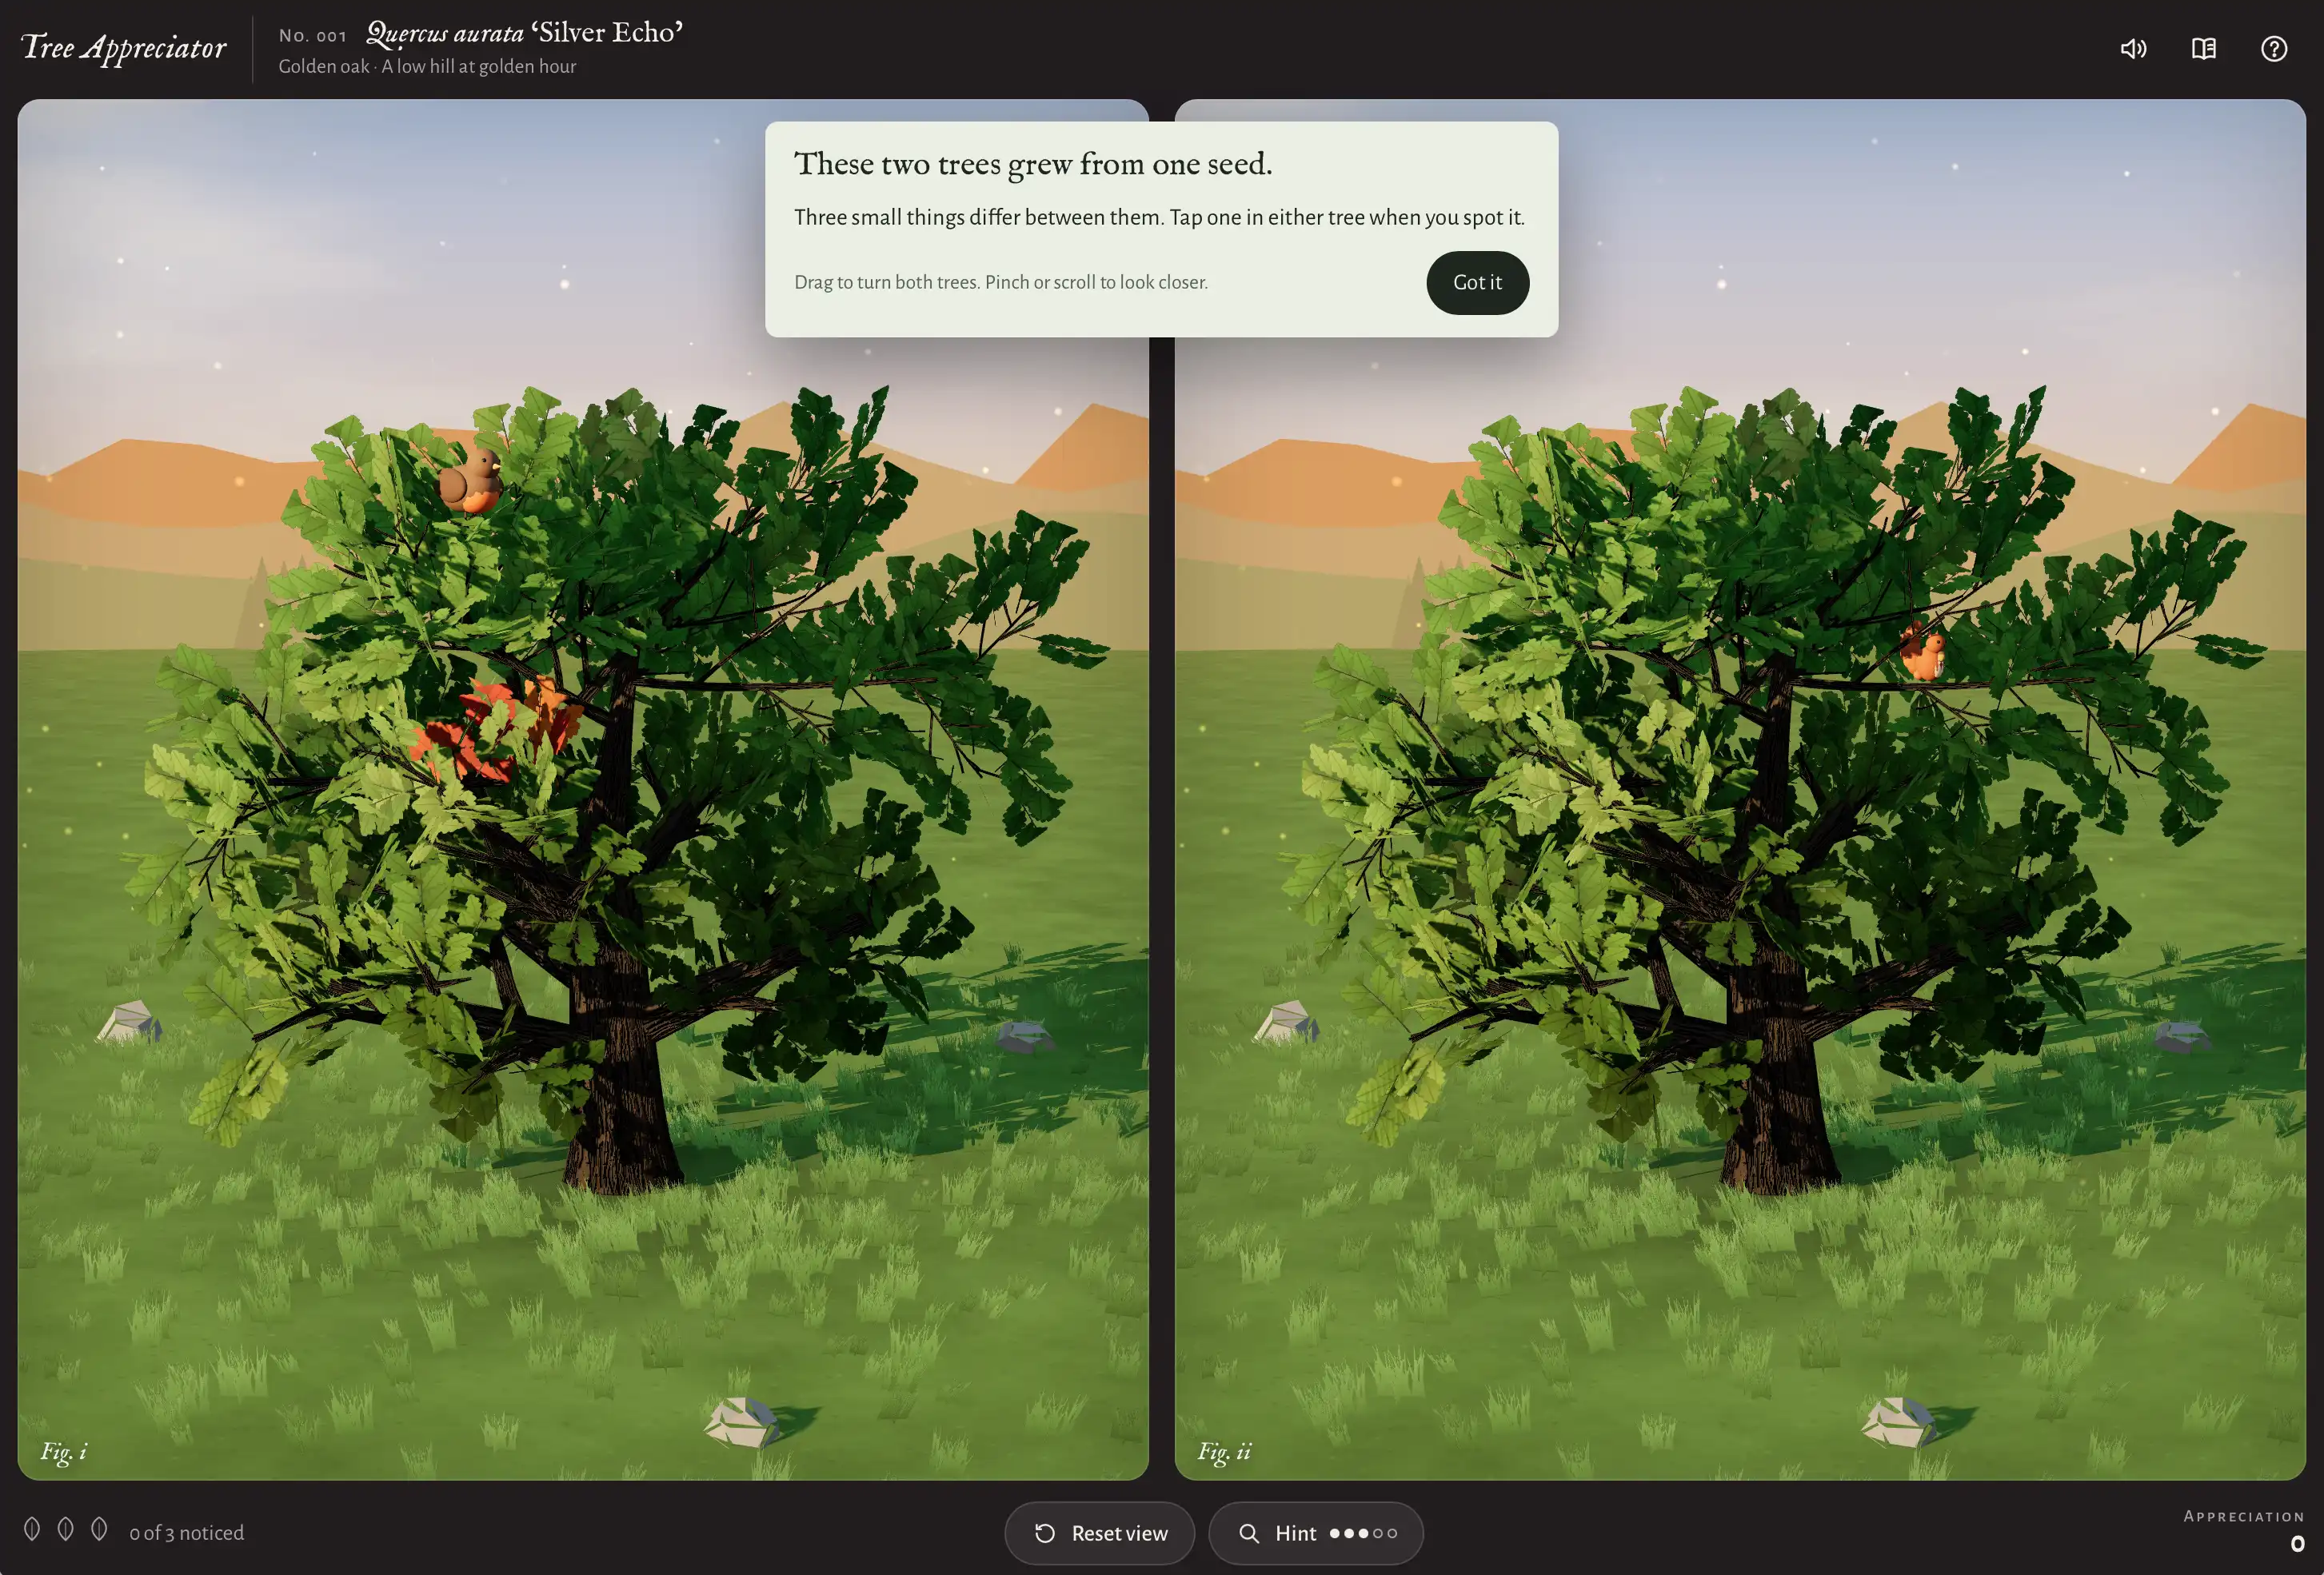
Von KI geschrieben Simon Willison argumentiert, dass der Oktober 2026 einen Wendepunkt für das Erstellen von Computerspielen durch Vibe Coding markierte, und schreibt Anthropics Claude Opus 5.5 ein echtes Gespür für unterhaltsames Gameplay zu. In den letzten Wochen entwickelte er vier Browserspiele in HTML und JavaScript, darunter Tree Appreciator, ein Fantasy-RPG, sowie den Echtzeit-Strategietitel Battle Drones, den er unter der Apache 2.0 License veröffentlichte. Laut ihm benötigte keines der Projekte mehr als vier Stunden eigenen Aufwand, und er bewertete GPT-6 Astra als noch nicht auf dem Niveau von Opus 5.5, wenn es darum geht, Spiele unterhaltsam zu machen. Außerdem merkte er an, dass die breitere Gaming-Community KI-generierten Assets weiterhin feindselig gegenübersteht.
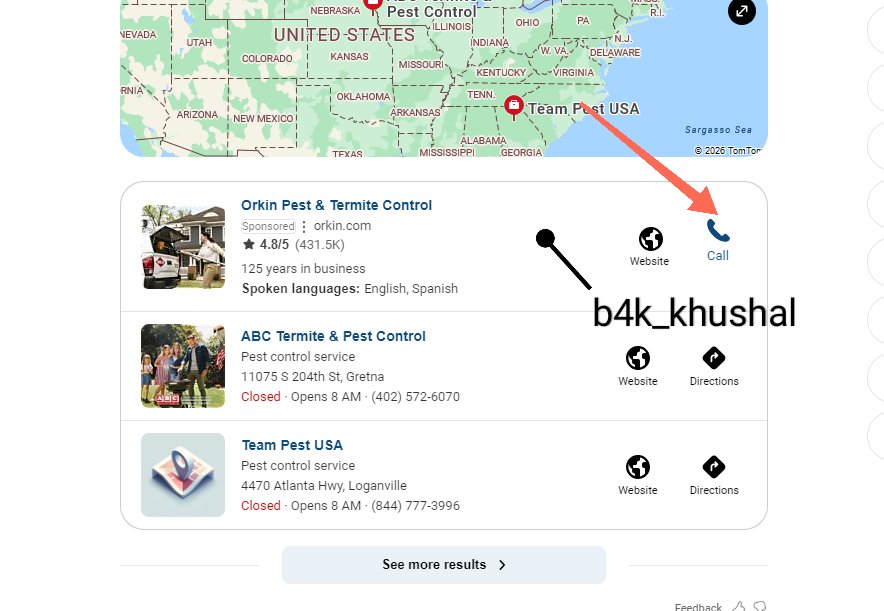
Von KI geschrieben Microsoft Bing testet in seinem lokalen Desktop-Block ein Telefonsymbol, das beim Klicken die Nummer eines Unternehmens zusammen mit einem QR-Code anzeigt, den Nutzer scannen können, um einen Anruf zu starten. Khushal Bherwani bemerkte die Funktion und berichtete auf X darüber; sie erschien als Erweiterung in gesponserten Anzeigen. Google hatte 2023 eine vergleichbare Option eingeführt.
Von KI geschrieben Terk Terkowitz schrieb in einem Update der Amazon-Ingenieursleitung zur Rolle der Entwickler in der KI-Ära und sagte, Ingenieure, deren Arbeit von den heutigen KI-Tools nichts profitiert, sollten dies als Ergebnis und nicht als Mangel betrachten. Er forderte sie auf, die Gründe festzuhalten, sie mit Kollegen und ihrem Vorgesetzten zu besprechen und nach Lösungen zu suchen. Zu erklären, wo KI an Grenzen stößt, zeige das Urteilsvermögen, das das Unternehmen erwarte, fügte er hinzu. Das Zitat wurde am 28. Oktober 2026 geteilt.
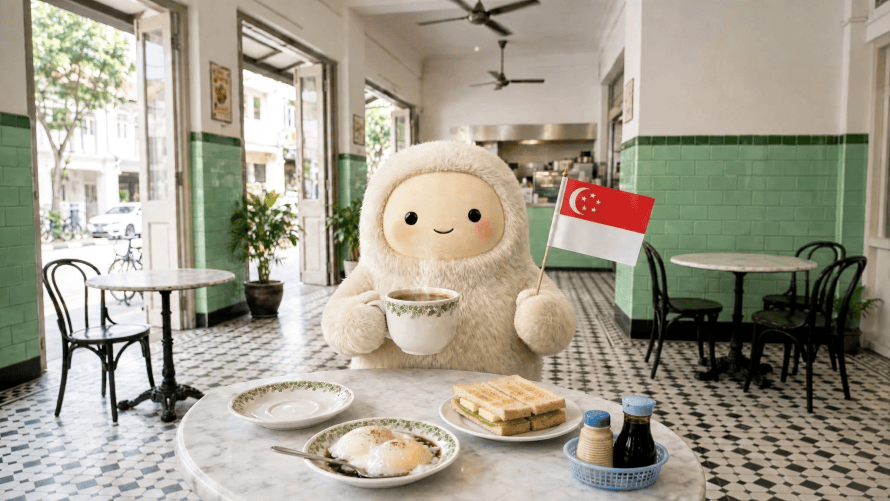
Von KI geschrieben Nutzer in Singapur können Muse, den persönlichen KI-Agenten von Meta, jetzt über muse.ai oder die iOS- und Android-Apps testen, und die Unterstützung für KI-Brillen ist auf dem Weg. Er verbindet sich mit Diensten wie Gmail und Instagram, und lokale Partner wie Grab, Shopee und Singapore Airlines sowie weitere übernehmen Shopping, Gastronomie und Reisen, wobei einige Connector-Funktionen später folgen. Der Agent läuft in Muse Secure VM, einem Cloud-Computer, der Passwörter und Zahlungsdaten von ihm fernhält, und fragt Nutzer vor Schritten wie Käufen nach. Bezahlte Abos decken intensivere Nutzung ab, während die meisten Funktionen kostenlos sind.
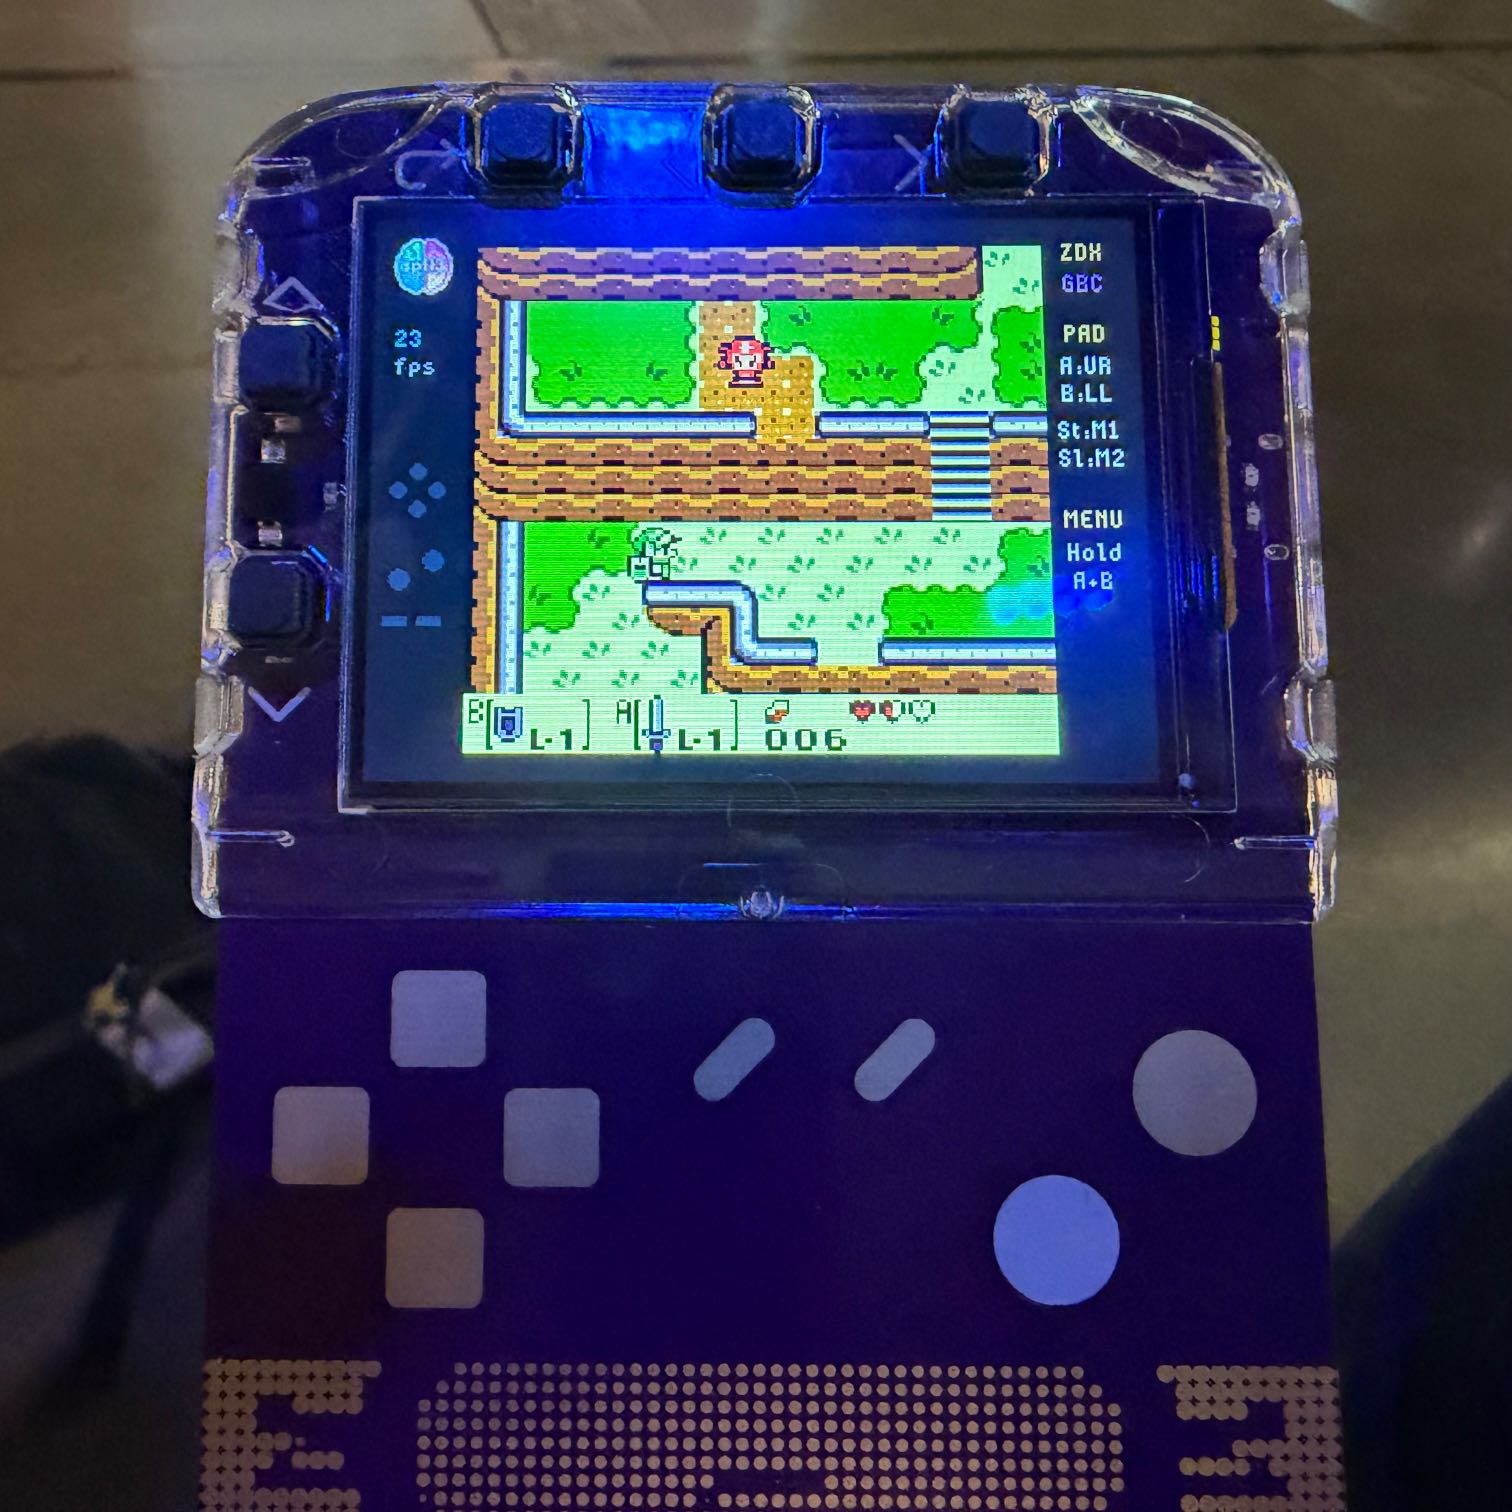
Von KI geschrieben Teilnehmer der GitHub Universe erhielten einen Konferenz-Badge, der zugleich als kleiner Computer mit Farbdisplay dient. Steve Francia nutzte Gemini, um einen NES-Emulator auf dem Gerät zum Laufen zu bringen, und ergänzte dann Unterstützung für Game Boy- und Game Boy Color-Titel. Mit einer ROM kann der Badge The Legend of Zelda: Link's Awakening spielen, und wird er umgedreht, erscheinen auf dem Gehäuse Touch-Tasten, die als Spielsteuerung dienen.
Von KI geschrieben Die Google-Research-Wissenschaftler Ali Behrouz und Vahab Mirrokni haben zusammen mit Co-Autoren ein Framework vorgeschlagen, in dem große Sprachmodelle zwischen einer aktiven Phase und einer Offline-Schlafphase wechseln. Während des Schlafs schaltet das Modell zusätzliche Mixture-of-Experts-Speicherblöcke frei, überführt Kurzzeitkontext in Langzeitgewichte und trainiert mit selbst erzeugten „Träumen“, um seine Fähigkeiten zu schärfen. Das Team berichtet von nahezu perfekten Ergebnissen beim BABILong-Benchmark bei bis zu 10M Tokens und von fast keinem Verlust beim nacheinander erfolgenden Lernen unbekannter Sprachen wie Mandschu und Kalamang. Bei Mathetests erreichte die Genauigkeit 79,2 % bei AIME 24, 69,0 % bei AIME 25 und 46,1 % bei HMMT 25 und übertraf damit SFT, GRPO und andere Baselines.
Von KI geschrieben Ai2 hat eine Studie mit dem Titel Old Ideas, Novel Problems veröffentlicht, zusammen mit einem Benchmark, Daten und Code, um zu testen, wie gut große Sprachmodelle die Originalität von Forschungsideen bewerten. Mit ICLR-2026-Peer-Reviews stellte das Team 154 Ideen von Menschen mit hoher Neuheit und 145 Ideen von Menschen mit geringerer Neuheit sowie 154 KI-generierte Ideen zusammen und testete sechs Bewerter, darunter GPT-5.4 und Claude Opus 4.6. Eine geringfügige Änderung des Prompts senkte die Genauigkeit von GPT-5.4 bei Paaren aus menschlichen und generierten Ideen von 93,5 % auf 40,9 %. Ein einfacher Prompt für Claude Opus 4.6 erzielte einen Macro-F1-Wert von 0,854 für 2,59 $ und übertraf KI Scientist von Sakana KI (0,772, 82,05 $) und Idea Novelty Checker (0,642, 30,66 $).
Von KI geschrieben Ein Ingenieur, der im August 2025 Vice President of Technology bei Bold.org wurde, hat seine GitHub-Historie analysiert und festgestellt, dass die Arbeit mit parallelen KI-Agenten seine Produktivität auf das Tempo seiner Full-Stack-Jahre zurückgebracht hat. Bis zum 27. Oktober 2026 hatte er 2.102 Beiträge verbucht, mehr als in jedem vollen Jahr von 2021 bis 2025, und der August 2026 brachte mit 427 einen Rekord, der den Wert von 319 aus dem April 2020 übertrifft. Der Median an Wochentagen stieg auf 7 Beiträge, nach 3 oder 4 im Zeitraum 2022–2025, und Tage mit 24 oder mehr Beiträgen erreichten 16, zuvor einer pro Jahr. Er beschreibt die Aktivität als Schübe, die mit neuen Modellen und Arbeitsabläufen zusammenhängen, und sagt, dass der ständige Kontextwechsel zwischen Agenten ihn erschöpfter macht als früher.